【Oracle AI World 2026現地参加レポート⑬】AIに「信頼できる事実」を届ける分散型レイヤー:Oracle GoldenGate Data Fabricの全貌と今後の展望
2026.11.02
- Oracle Cloud Infrastructure(OCI)
- Oracle DB
- クラウド


こんにちは。DB技術統括部のT.Kです。ラスベガスにて、10/25~10/28にわたり開催されておりました「Oracle AI World 2026」の現地レポートをお届けします。
今回は受講した「Building a Data Fabric with GoldenGate, an AI Truth Layer for Data」のセッションレポートを投稿します!
はじめに
AIが判断を代行する現在、古いデータや不完全なデータは誤ったアクションに直結します。
どんなに優れた大規模言語モデル(LLM)であっても、入力されたデータが古ければ、誤った情報に基づいて行動してしまうだけです。
この課題を解決し、AIインフラへの「信頼できるデータ」の供給を担うのが、Oracle GoldenGate Data Fabricです。
Oracle GoldenGate Data Fabricとは
企業内に散在する「業務システム(記録のシステム)」と「データ活用基盤(データレイク、AI、分析ツール)」をリアルタイムにつなぐ、統合的なデータ連携プラットフォームです。
具体的には、主に以下のようなユースケースで利用されます。
ミッションクリティカルなデータ同期と移行: ゼロダウンタイムでのデータベース移行、災害対策としての高可用性(HA)構成、マルチクラウド間でのリアルタイムデータ連携を行います。
分析基盤へのリアルタイムストリーミング: 従来の夜間バッチ処理に代わり、データウェアハウスやデータレイクハウス(Databricks、Snowflake、BigQueryなど)へ、コミット済みのトランザクションデータを継続的かつミリ秒単位で供給します。
AIエージェント向けのデータ供給: 運用システムの変更をキャプチャし、LLM連携やベクトル処理を通じて、AIがそのまま利用できるガバナンスの効いた「データプロダクト」へとリアルタイムに変換・公開します。
Data Fabricはこれを「単一のファブリック(網目)」として統合管理します。業務システムで発生した変更を「一度だけ」キャプチャし、それをあらゆるプラットフォームやアプリケーションに分配できるのが最大の特長です。
AI環境へ「信頼できる事実」を直接届ける分散型レイヤー
AIの出力品質は入力データの品質に依存する「Garbage in, garbage out(ゴミを入れればゴミが出る)」の原則があります。多くのデータプラットフォームはAIやアナリティクスに特化していますが、企業の業務システムから切り離されているため、情報に遅れが生じがちです。
GoldenGate Data Fabricは、この業務システムとAIの隙間を埋める「AIのための分散型真実(Truth)レイヤー」として機能します。ソースシステムでトランザクションがコミットされると、その変更を順序通りにキャプチャし、コンテキストを保持したままデータプロダクトへと変換します。これにより、AIは昨晩のバッチデータではなく、数秒前に発生したリアルタイムの事実に基づいて行動できるようになります。
データプラットフォームとしての今後の展開と3つの価値
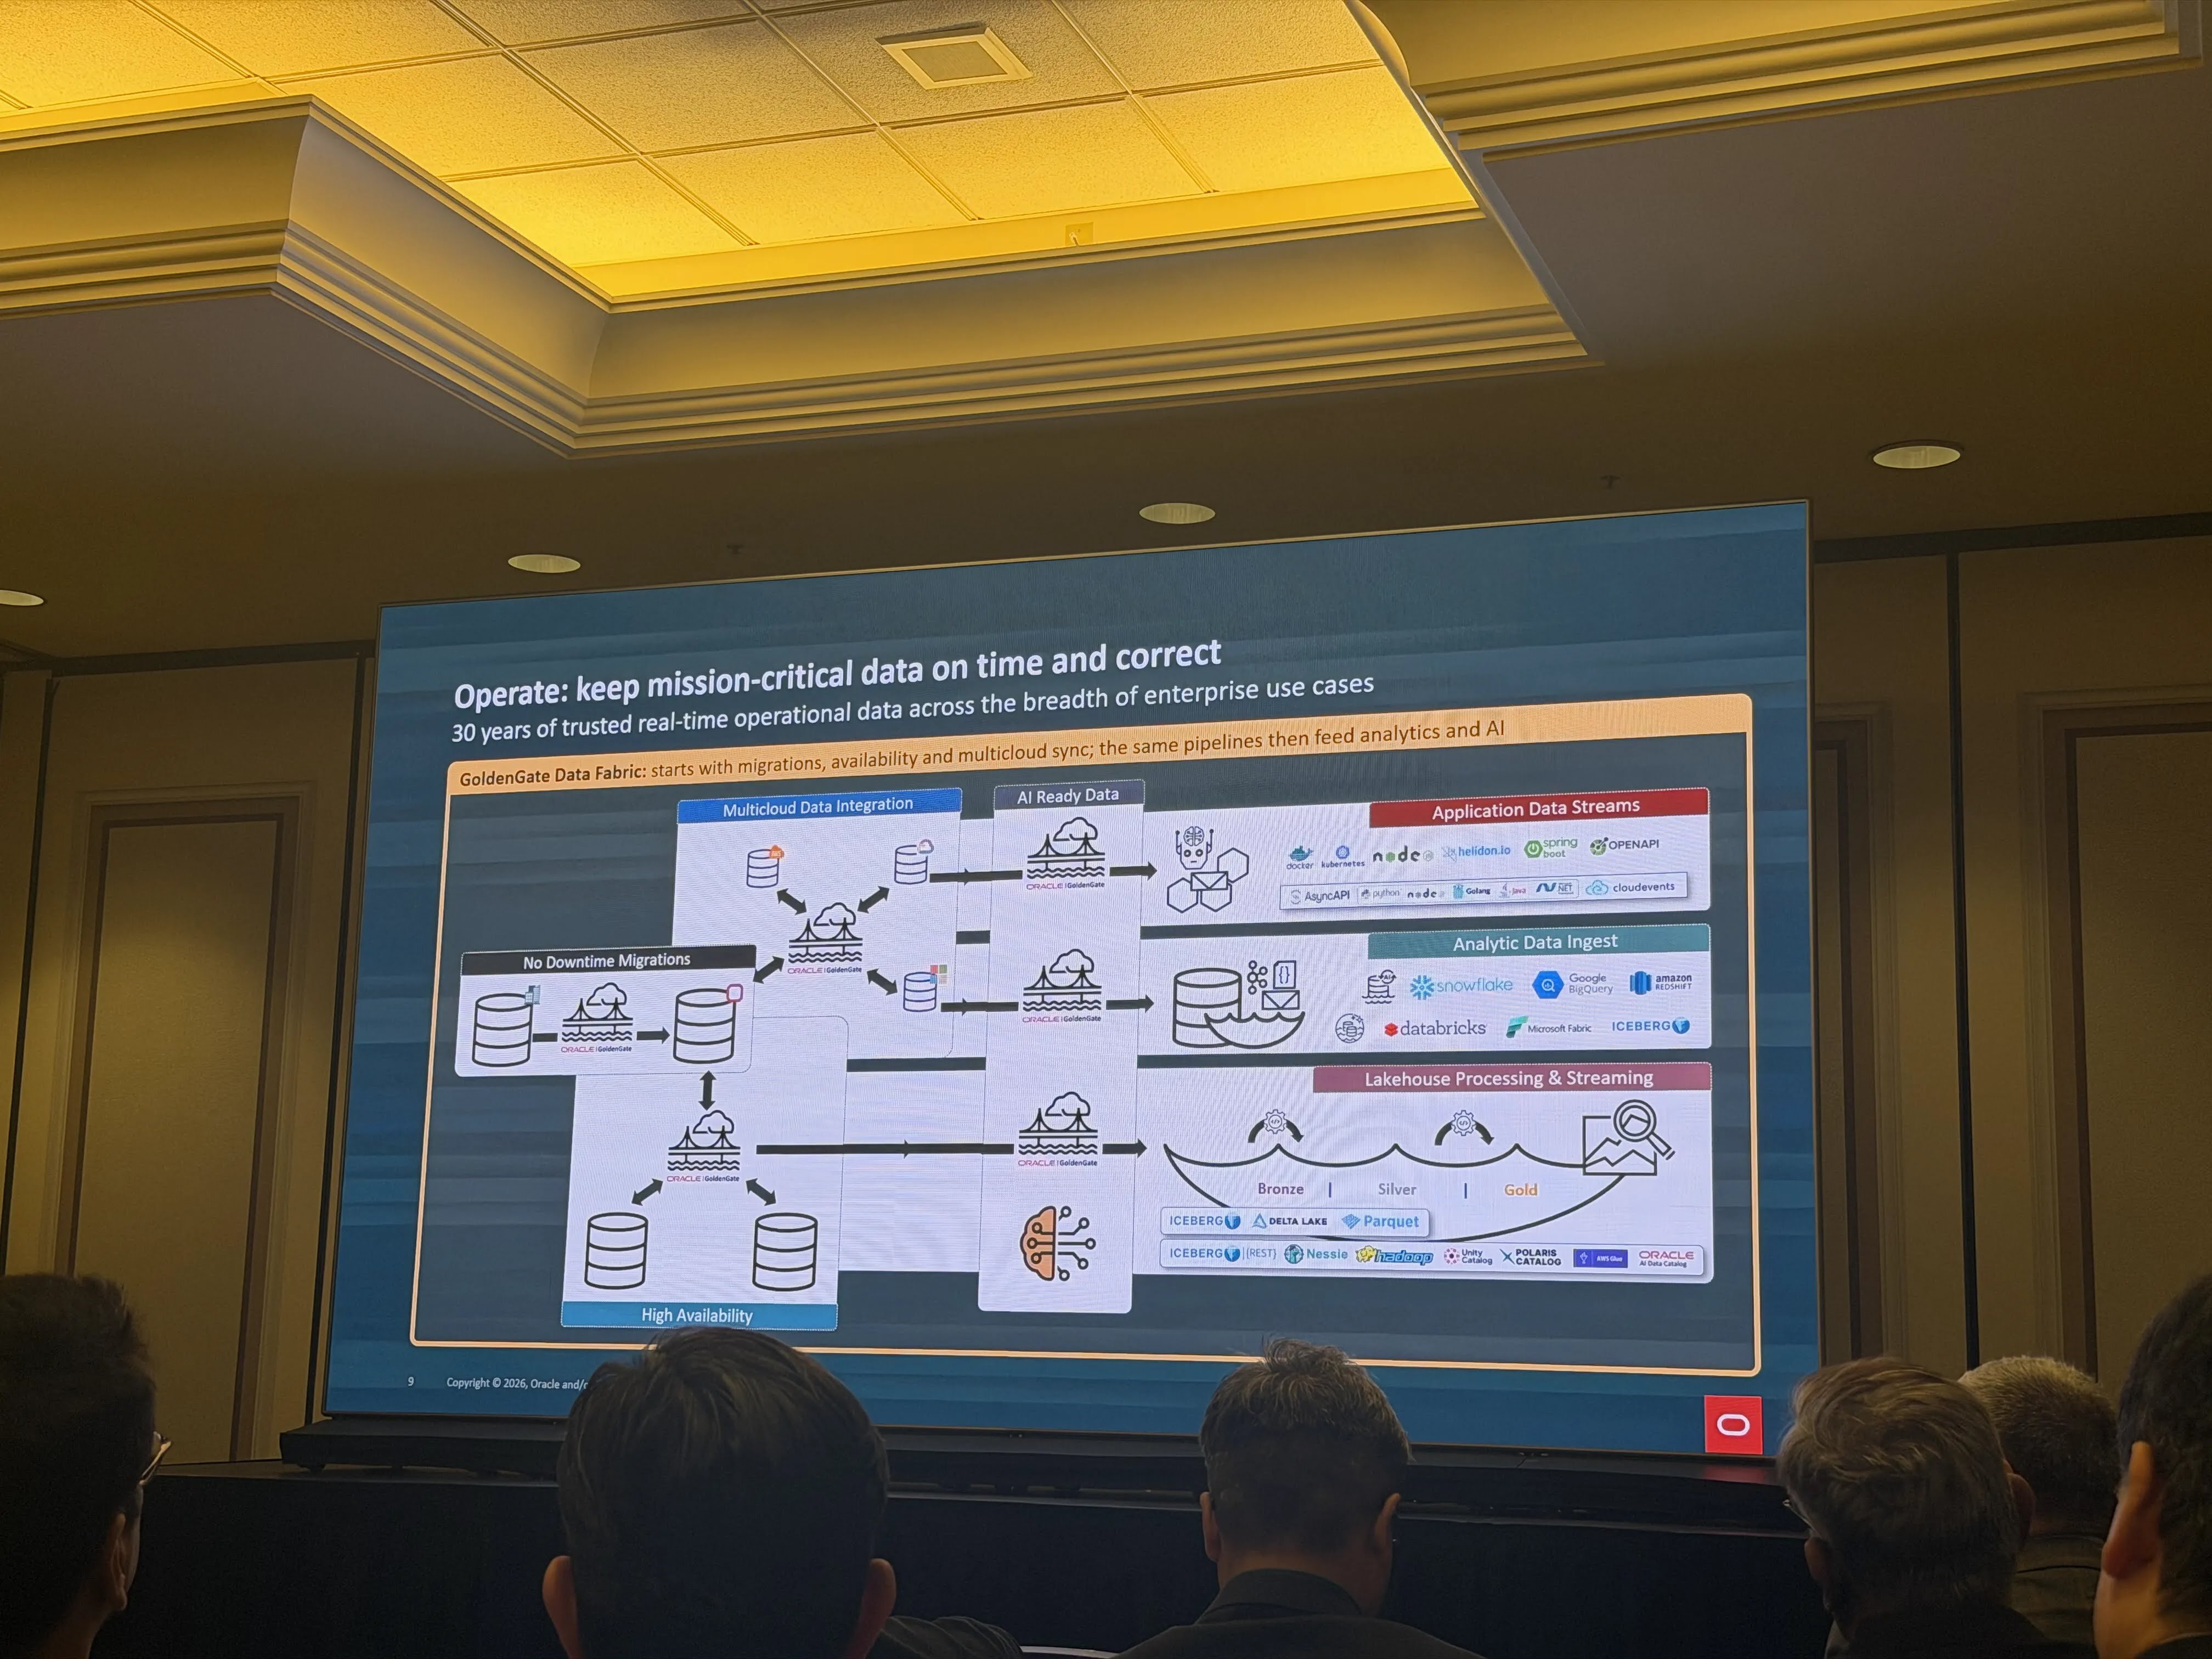
GoldenGateは過去30年間にわたり、ミッションクリティカルなシステム間で「遅延も誤りも許されないデータ」を同期するエンタープライズ標準として信頼を築いてきました。これからのGoldenGateは単なるデータ連携ツールにとどまらず、データインフラ全体を最適化するプラットフォームとして、以下の3つの価値を展開していきます。
1. Operate(運用):変化の中でもミッションクリティカルな業務を継続
データレイクハウスは情報を蓄積・分析する強力なデータ基盤ですが、実際のビジネストランザクションが発生する運用システム(記録のシステム:SoR)ではありません。GoldenGateはこれまで、ミッションクリティカルな運用システム間のデータ同期を提供してきました。これからは、運用システム間で同期されているのと同じリアルタイムの変更データが、データレイクハウスや各種アプリケーション、AIエージェントにも直接ストリーミングされます。データの利用先ごとに個別の処理を構築するのではなく、統合された単一のパイプラインによる効率的な運用を実現します。
2. Activate(活用):コミットからアクションまでの遅延を劇的に短縮
データプロダクトとして最新情報が絶えず供給されることで、企業は「コミットからアクションまでの遅延時間(commit-to-action latency)」を最小化できます。夜間バッチ処理に依存した場合の1日の遅延が数秒に短縮されれば、AIエージェントは推測に頼らず、確定した最新の在庫や注文状況に基づいた確実な対応が可能になります。
3. Optimize(最適化):ワークロードを経済性に優れた場所に配置
クラウド環境やデータ処理エンジンの選択肢が多様化する中、プラットフォームごとに価格や性能の条件は常に変化します。同じApache Sparkのパイプラインであっても、実行するマネージドプラットフォームの違いによって約54%※ものコスト差が生じる場合があります。GoldenGate Data Fabricは、データパイプラインやガバナンスの設計を特定のベンダーから切り離して保持するため、経済性の変化に合わせて最も適したクラウドや計算エンジンへワークロードを柔軟に移動させることができます。
まとめ〜「ファブリック」を標準化する〜
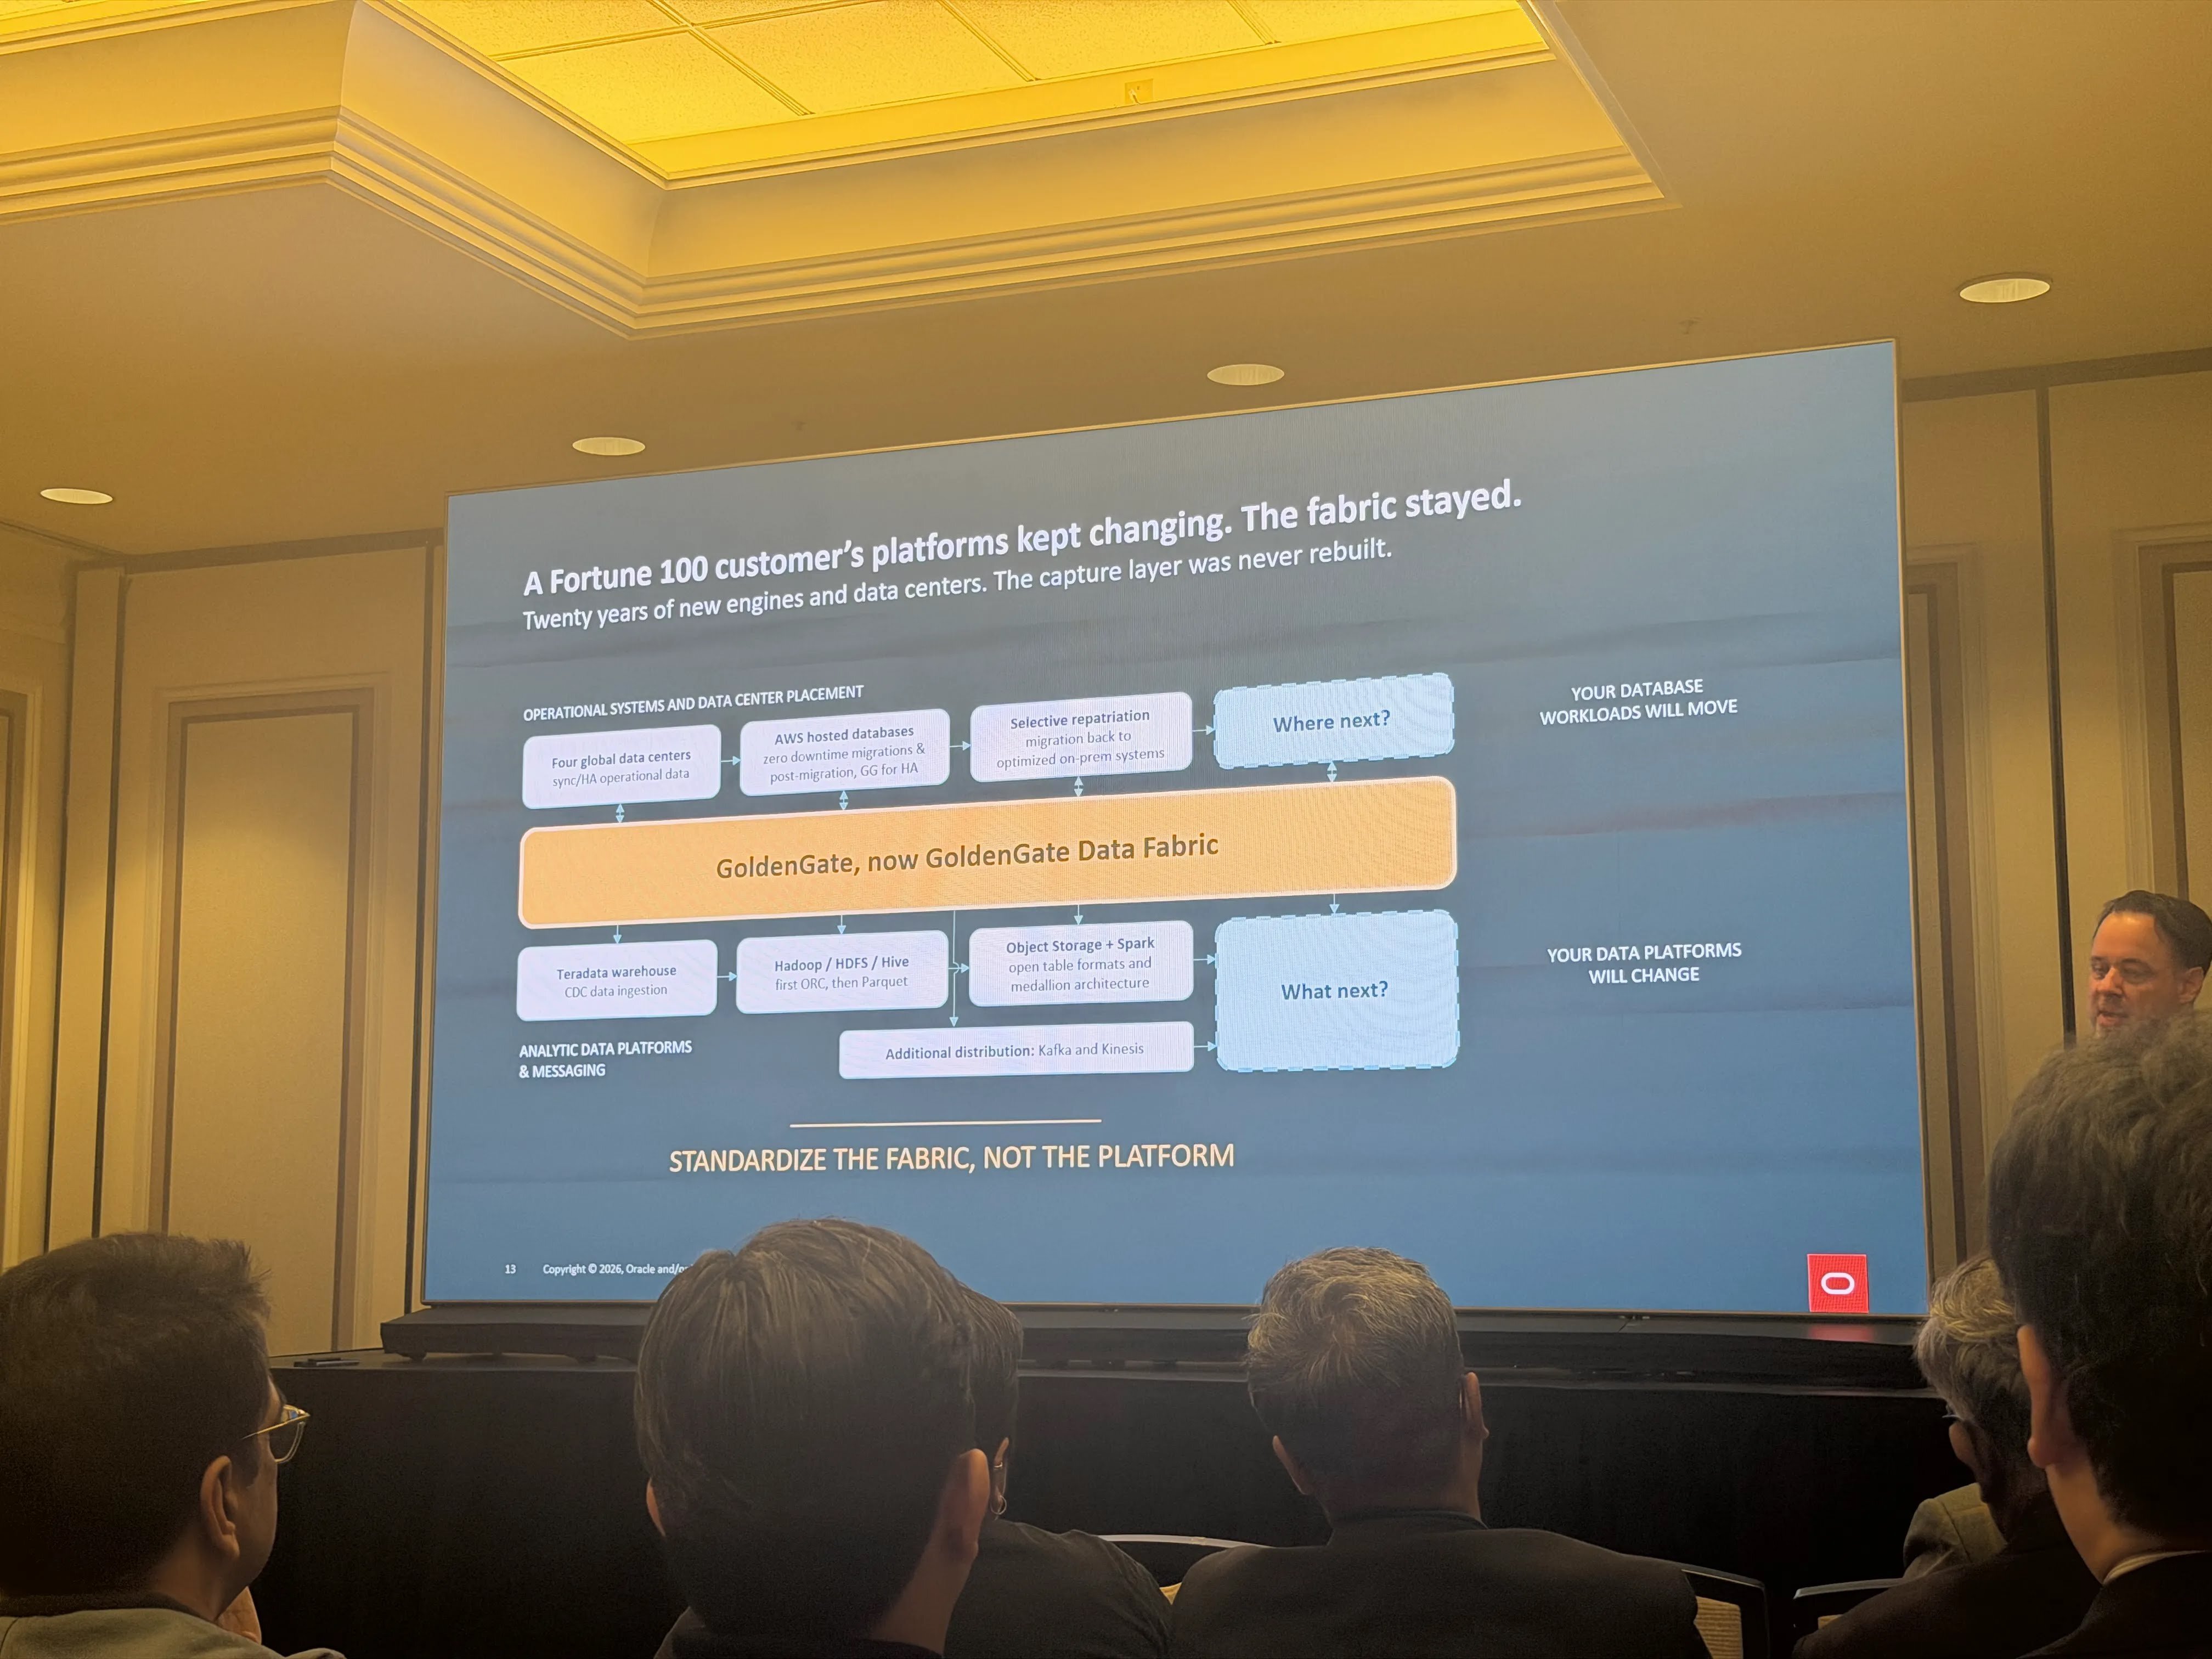
企業のIT環境は単一のプラットフォームに留まらず、常に変化し続けます。あるFortune 100企業のお客様は、約20年間にわたりTeradata、Hadoop、Kafka、各種クラウドやレイクハウスへとデータプラットフォームの移行を繰り返しましたが、データの抽出を担うGoldenGateのキャプチャ層(ファブリック)が再構築されることはありませんでした。データベースや分析基盤の移行が発生しても、変更ストリームというファブリックを標準にしておくことで、長期的なアーキテクチャの安定性が確保されます。
これからは、「自社のAIがどれほど古いデータに基づいて自律的な判断を下しているか?」を問いかける必要があると感じられました。信頼できるデータに基づくアクションを実現することが、AI戦略を成功に導く鍵となりそうです。
SNSでもイベント当日の様子を掲載しています!ぜひチェックしてみてください!
(Re:Q 公式Xアカウント)@reqtc
(Re:Q 公式Instagramアカウント) @reqtc
(Re:Q DB部エンジニアXアカウント) @db_reqtc
RELATED ARTICLE関連記事
2026.02.17
OCI Exadata Database Service Exascaleへの期待
- Oracle Cloud Infrastructure(OCI)
- Oracle DB
2025.12.26
【OCI基礎知識】OCIのIAMとは?
- Oracle Cloud Infrastructure(OCI)
- Oracle DB
- クラウド
2026.04.17
【Oracle AI World Tour Tokyo 2026 現地参加レポート②-3】オープニング基調講演 「Oracle AI:ビジネスとともに進化するAIの最前線」-レポート後編-
- Oracle Cloud Infrastructure(OCI)
- Oracle DB
- 生成AI
RELATED SERVICES関連サービス
Careersキャリア採用


この記事をシェアする