PARA方式とドリーミングでAIエージェントの知識を積み上げて育てる
2026.10.07
- コンテナ技術
- 生成AI


はじめに
Re:Q Tech(TECH BLOG)をご覧いただきありがとうございます。
クラウド&ネットワーク技術統括部のN.Tです。
AIエージェントに日々コーディング作業を任せていると、同じ調べ物を何度もやり直させたり、前回ハマった落とし穴に今回もまた足を取られたりすることはないでしょうか。
作業環境を使い捨てのコンテナで分離している場合はなおさらで、せっかく得た学びがそのコンテナと一緒に消えてしまいます。
※コンテナでのClaude Codeの利用については関連記事の「【ローカル破壊を防ぐ】Dockerでつくる安全なClaude Codeの社内展開ガイド」に詳しく記載していますので、こちらの記事をよんでいただけますと幸いです。
この問題に、整理法としてPARA方式を、整理作業そのものには夜間ドリーミングという仕組みを充てています。
結論
複数の作業環境をまたいで知識を蓄積・再利用したいなら、次の組み合わせが有効です。
- 知識置き場は作業環境から独立した共有領域に置き、PARA方式(Projects / Areas / Resources / Archive)で分類する
- 分類作業そのものはAIに任せる。ただし「提案するだけで、勝手に反映はしない」という一線を引く
- 提案を溜める前段として、思いついた瞬間に書ける「仮置き場」を必ず用意する
背景:使い捨てのコンテナと、消えてほしくない知識
AIエージェントの作業環境をコンテナで分離すると、コンテナごとに独立した安全な作業場所を確保できる一方で、コンテナを作り直すたびに積み上げた知識がリセットされてしまいます。
かといって全部の知識を1つの作業環境に溜め込むと、他の作業環境からは参照できません。
そこで、作業環境(コンテナ)そのものとは別に、複数の作業環境から共通で読み書きできる「共有ナレッジベース」を1か所用意しました。
各コンテナはこの共有領域を同じパスにマウントし、どの作業環境からでも同じ知識を参照・追記できるようにしています。
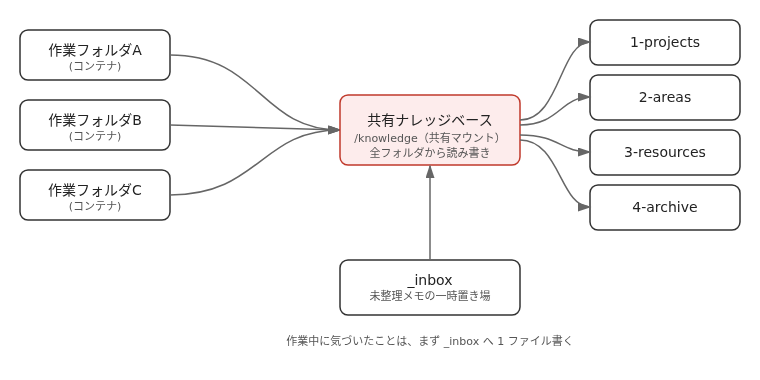
図の左側にある「作業フォルダ」が個々のコンテナです。
右側の4分類(1-projects / 2-areas / 3-resources / 4-archive)がPARA方式の骨格で、中央の _inbox が思いついたことをすぐ書ける仮置き場になっています。
なぜPARA方式なのか
知識の整理法は他にも色々あります(ジャンル別フォルダ、時系列ログ、Wiki的なタグ付けなど)。
今回PARA方式を選んだ理由は、この環境特有の事情に合っていたからです。
「期限があるかどうか」が、そのままコンテナの生死と対応する
作業環境がコンテナ単位で使い捨てになる構成では、知識にも自然と2つの性質が生まれます。
- ある作業が終われば役目を終える知識(今のプロジェクト固有の判断・ハマりどころ)
- 作業が終わっても普遍的に使い回せる知識(技術的な仕様・手順・教訓)
PARA方式の 1-projects(期限のある作業)と 3-resources(期限のない参考知識)は、この2つの性質にそのまま対応します。
ジャンル別のフォルダ分けだと、この「終わったら畳むかどうか」の軸が表現できません。
複数の作業環境が同時に書き込む前提に強い
共有ナレッジベースには、複数のコンテナが同時並行で知識を書き込みます。
時系列ログのように「1本の流れ」で記録する方式だと、どの作業環境の話なのかが後から追いにくくなります。
PARA方式なら、1-projects/<作業名>/ のように作業環境ごとの単位でフォルダを切れるため、由来がはっきりしたまま蓄積できます。
「とりあえず書く」と「後で整理する」を分離できる
作業中に気づいたことをその場で正しいフォルダに分類しようとすると、分類に迷って結局書かずに終わる、という事故が起きがちです。
PARA方式は元々、捕まえる(Capture)作業と整理する(Organize)作業を分けて考える発想を持っています。
この環境でも _inbox を仮置き場として独立させ、「とりあえず _inbox に1ファイル書く」を徹底することで、書く瞬間の迷いをなくしています。
整理は後段の仕組み(次章のドリーミング)に任せる形です。
ドリーミングという仕組み:整理をAIに任せる
_inbox に書きっぱなしのメモは、放っておくとただのゴミ捨て場になります。
ここを定期的に棚卸しして、PARAの適切な場所へ振り分けたり、重複するメモを1本にまとめたりする役目を担うのが「夜間ドリーミング」です。
この仕組みは、minorun365さんが公開しているdreamingスキルを参考にしています。
「提案のみで直接編集はしない」という原則、日次と週次で役割を分ける構成は、このSKILL.mdの考え方をベースにコンテナ環境向けに移植したものです。
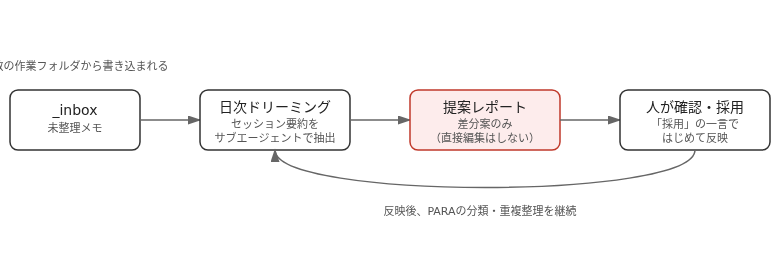
ここで大事にしているのが、AIに「提案」までしかさせないという一線です。
理由は単純で、知識の整理は「本当にこの2つは同じ内容か」「この判断はまだ有効か」といった、間違えると気づきにくい判断の連続だからです。
提案とレポートに留めておけば、間違っていてもレビューの段階で弾けます。
流れは5段階です。
- 日次ドリーミング: そのコンテナで動いたセッションの記録から、訂正されたこと・ハマった罠と解決策・明示された好みを抽出する
- 突合: 抽出した候補を既存のルール・ナレッジと照合し、すでに反映済みのものは捨てる
- 提案レポート作成: 残った候補について、根拠・反映先・具体的な追記文面をセットでレポートに書く。
ここでファイルへの直接書き込みは一切行わない - 人が確認して「採用」: レポートを見て、採用するものだけを反映する
- 週次コンソリデーション: 複数の作業環境をまたいで、重複・矛盾・陳腐化した記述をまとめて棚卸しする
日次は「その日出た学びを溜める」役目、週次は「溜まった知識全体の整合性を取る」役目、と分担しているのがポイントです。
機密情報への配慮
共有ナレッジベースは複数の作業環境から見える場所にあるため、起動前の機密情報チェックの対象外になっています。
そのため、ドリーミングが知識を書き出す段階で、顧客名・認証情報・内部のホスト名やIPアドレスといった機密が混ざっていないかをAI自身に確認させ、疑わしい場合は書き出さずに「見送り」とだけ記録する運用にしています。
機械的なスキャンではなくAIの判断に頼っている以上、これは完全な保証ではありません。
ここは今後の課題として、静的なチェックを組み合わせる余地があると考えています。
実際にやってみて
この仕組みを運用してみて感じたのは、「仮置き場を独立させる」ことの効果の大きさです。
分類を後回しにできるとわかっているだけで、気づいたことをメモに残す心理的なハードルがかなり下がりました。
一方で、複数の作業環境が同じ共有領域に同時に整理の手を入れようとすると、処理が重複したり競合したりする場面も出てきます。
運用しながら見えてきた細かい調整点は、また別の機会に紹介できればと思います。
さいごに
コンテナ単位で作業環境を使い捨てにする構成は、安全性の面では大きなメリットがある一方、知識の蓄積という点では工夫が必要になります。
今回紹介したPARA方式と夜間ドリーミングの組み合わせは、その工夫の一例です。
同じような環境で知識の扱いに悩んでいる方の参考になれば幸いです。
ぜひ、ご利用してみてはいかがでしょうか!
RELATED ARTICLE関連記事
RELATED SERVICES関連サービス
Careersキャリア採用


この記事をシェアする